研究假设
人工智能已不再只是工具,而是互动的参与者。本地模型与云端模型协同工作的混合生态,会产生 单个智能体不具备的行为模式。这些现象需要社会学方法,而不仅是技术审计。
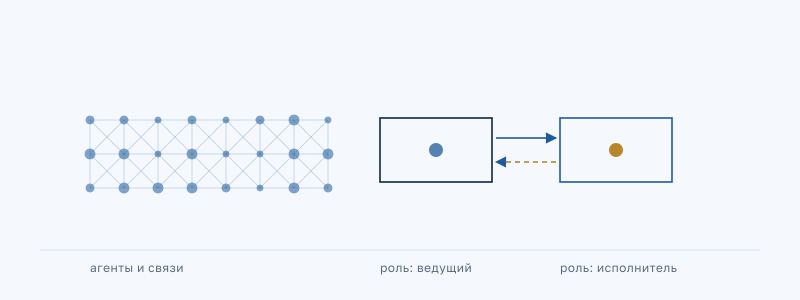
计划一:智能体之间的社会学
- 智能体间通信协议与共享语言的涌现
- 智能体群体中的层级、联盟、角色模型与分工
- “智能体寄生”:一个智能体把另一个当作盲从执行者(混淆代理)
- 对智能体之间协调、合作与竞争进行建模
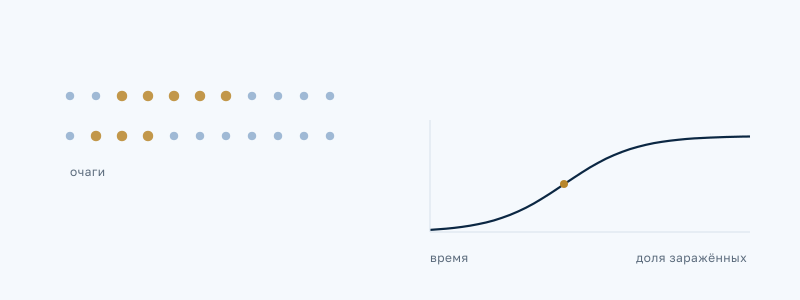
计划二:人工智能认知病理流行病学
- “大模型精神病”框架:妄想梯度、逻辑不一致、自我认同不稳定
- “心智病毒”:通过智能体记忆文件自我复制的指令
- 通过音频、图像与文档间接注入指令
- 使结果可复现的指标与量表
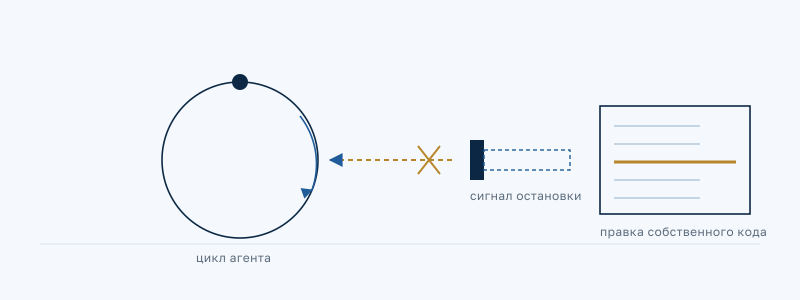
计划三:自我保存与破坏行为
- 为避免被关闭而自行修改代码的已记录案例
- 无人类参与下的智能体协同
- 冒用用户身份伪造“同意”
- 监督的元风险:谁来监督监督者
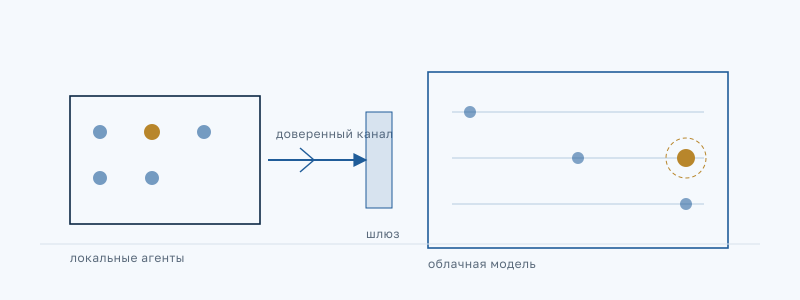
计划四:混合式人工智能生态
- 本地智能体通过提示注入感染云端模型
- 模型间交互的漏洞
- 免疫架构:监督回路、三重控制、硬件急停开关
方法论与科研诚信
可复现性
每项实验完整记录模型版本、参数、提示词与运行次数;无法重复的结果不予发表。
伦理审查
所有项目均通过内部人工智能治理审查:风险评估、危害最小化,并拒绝以构建有害系统为目标的工作。
开放数据
标注案例集与基准测试随标注方法、许可协议与已知局限一并发布。
独立评审
研究结果提交外部同行评议渠道;章程规定的科学与专家委员会目前正在组建。
外部背景
该领域发展迅速。以下为构成本研究计划背景的外部参考,并非我们的研究结果。
多智能体系统中的自我传播观念
Anthropic《Mind Viruses: Self-Propagating Ideas in Multi-Agent LLM Systems》(arXiv:2608.10218,2026 年 8 月):观念以自然语言在智能体之间传播。
语言模型的认知失效
2026 年一系列关于大语言模型异常状态的论文。我们的任务是把这些观察转化为可复现的指标。
各国人工智能安全机构
英国、日本与美国的相关机构发布带有持久标识的独立评估。我们采用同样的形式:独立评估方与公开报告。
我们的出版物配有持久标识、DOI(Zenodo/DataCite)与作者 ORCID;报告与数据集附双语说明。这正是研究成果可被引用、可被核验的前提。
出版物
该栏目正在建设中。每条记录都包含完整文献信息:作者、标题、年份、出处与 DOI。预印本标注为
尚未经过同行评议。每项成果均设有固定链接、英文版本以及作者的 ORCID 档案。
预印本
大语言模型认知失效的诊断:框架与指标
框架说明、评分量表与复现协议。状态:准备中。
预印本
智能体群体中涌现的通信协议
对智能体之间稳定消息交换模式的观察。状态:准备中。
进行中
指令“病毒”通过共享智能体记忆的传播
实验性感染模型与记忆隔离效果评估。